drk7.jp
pound と apache をバランスよくチューニングする必要性について
16年前に書いた記事です。製品やサービスの情報は公開当時のものです。
目次(6項目)
もう二ヶ月ほど前の話なのですが、お仕事で「サイトが異常に重い(遅い)んだけど・・・」という苦情が月に1〜2件ほどきていたので、重い腰を上げて本格的に調査・解析して、pound と apache のチューニングを実施しました。チューニング後はサイトが重いという苦情は皆無になりました。(≧∇≦)b
今回のチューニングのキモは、pound と apache をバランスよくチューニングするということでした。完全に見落としていた点でもありました。
苦情がきていた時点の構成
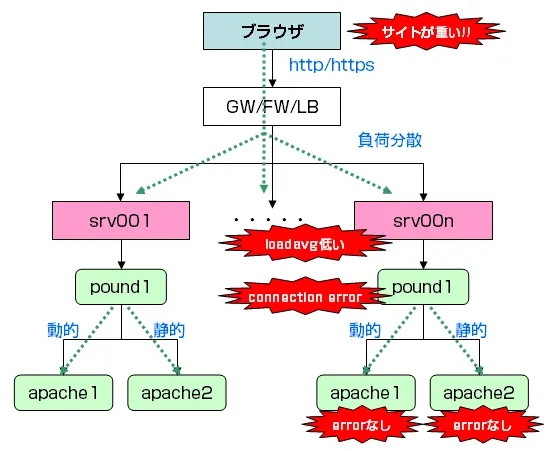
とりあえず苦情がきてた時点までの構成を図にするとこんな感じでした。ブラウザからの http/https のアクセスは GW/FW/LB で srv001〜srv00n に負荷分散されます。各サーバでは pound が受けて、動的コンテンツは apache1、静的コンテンツは apache2 に振り分けています。
何しろ Web サーバの Load Average も CPU 負荷も高くないので、サーバ側は悪くないという思い込みが原因特定を遅らせた一番の原因。この2つの数値はとっても重要なのですが、この数値に真実の見極めを惑わされてはいけません。
以下、調査手順など備忘録的なメモ。途中かなり寄り道したり脱線したりして、答えにたどり着きませんでしたが、答えの道だけ残しておきます。
apache1/apache2 の切り分け
申告では、静的/動的にかかわらずサイトが重たいらしい。また不特定のページでブラウザが固まるような挙動らしい。
とすると、apache レベルではなく上位の pound 側かな?
少なくとも apache1/apache2 のエラーログには connection エラー系の出力はないことを確認しました。
Pound1.9 を疑ってみる
Pound1.9 のログには何種類かの warning が出力されていることを確認。もともとそういうモノだと思い込んでいたのだが、実は重要な手がかりが隠されていました。warning の一部を種類別に抜粋します。
Sep 20 04:04:20 srv002 pound: bad header from 110.163.250.169 (-------: ----:---------------)

Sep 20 06:57:47 srv002 pound: error copy server cont: Connection reset by peer
Sep 20 07:13:56 srv002 pound: error copy chunk cont: Connection reset by peer
Sep 20 08:55:35 srv002 pound: error flush headers to 125.161.138.151: Connection reset by peer
Sep 20 04:51:56 srv002 pound: error final flush to 219.94.151.134: Connection reset by peer

Sep 20 08:10:45 srv002 pound: error read from 59.138.209.51: Input/output error

Sep 21 07:20:24 srv002 pound: error copy server cont: Connection timed out
Sep 20 15:04:54 srv002 pound: error copy client cont: Connection timed out
Sep 20 11:20:17 srv002 pound: error read from 203.112.76.3: Connection timed out
それぞれのエラーの意味を調べてみる。
- bad header from エラーの原因は、pound1.9 が未対応もしくは不正な header が送信された時のエラー。
- Connection reset by peer エラーの原因は、ブラウザとサーバ間の通信が切れた事(多くの場合はブラウザが閉じられた、もしくはコンテンツを返す前に他のページに遷移済み)によるエラー。
- Input/output error は pound1.9 の get_headers 関数の bug かもしれない(ソース解析から推測)。
- Connection timed out は、ブラウザとサーバ間でタイムアウトが発生して通信が切れた事によるエラー。
pound 1.9 の http.c のソースから、ログに出力されている部分を処理しているコードを抜粋してみます。
[bad header]
    case HEADER_ILLEGAL:
        if(log_level > 0)
            logmsg(LOG_WARNING, "bad header from %s (%s)", inet_ntoa(from_host), headers[n]);
        headers_ok[n] = 0;
        break;

[error read]
if((headers = get_headers(cl, cl)) == NULL) {
    if(!cl_11) {
        if(errno)
            logmsg(LOG_WARNING, "error read from %s: %s", inet_ntoa(from_host), strerror(errno));
        /* err_reply(cl, h500, e500); */
    }
    clean_all();
    pthread_exit(NULL);
}

[error copy server cont]
        } else if(cont >= 0L) {
            /* may have had Content-length, so do raw reads/writes for the length */
            if(copy_bin(be, cl, cont, &res_bytes, skip)) {
                if(errno)
                    logmsg(LOG_WARNING, "error copy server cont: %s", strerror(errno));
                clean_all();
                pthread_exit(NULL);
            }

[error flush headers]
    /* final CRLF */
    if(!skip)
        BIO_puts(cl, "\r\n");
    if(BIO_flush(cl) != 1) {
        if(errno)
            logmsg(LOG_WARNING, "error flush headers to %s: %s", inet_ntoa(from_host), strerror(errno));
        clean_all();
        pthread_exit(NULL);
    }
Pound1.9 を疑い、最新の 2.45 へアップデートしてみる
pound1.9 → pound2.45 はメジャーバージョンアップということもあり、ソースコードを比較してみると、エラーのログレベルの変更やアルゴリズム変更が相当量あります。たとえばログ出力のレベル変更などが目立ちます。
pound1.9 では log_level=warn なのが、pound2.45 では log_level=notice に変更されているので、コンフィグの設定も notice にしないと同じ warning を捕捉できなかったりします。
その他、Input/output error エラーや bad header from エラーが解消されています。
2.45 で新たに出たエラー
しばらくの間、特定のサーバだけ pound 2.45 で運用をしてみたのですが、新たなエラーが発生してしまいました。アルゴリズムの違いによる新たな notice 情報です。
Sep 24 18:08:43 srv002 pound: (18d800e) error write response pending: Connection reset by peer
Sep 24 19:15:16 srv002 pound: (408a1960) e500 error copy client cont to 127.0.0.1:8080/POST /cgi-bin/app.cgi HTTP/1.1: Connection reset by peer (6.006 sec)
Sep 25 02:02:29 srv002 pound: (41616960) e501 bad request "OPTIONS / HTTP/1.1" from 210.170.141.215
またサーバ高負荷時には更に別のエラーが発生してしまいました。
Sep 29 20:24:55 srv002 pound: (44aa5960) connect_nb: poll timed out
Sep 29 20:24:55 srv002 pound: (44aa5960) backend 127.0.0.1:10080 connect: Connection timed out
Sep 29 20:25:00 srv002 pound: (42cf0960) connect_nb: poll timed out
Sep 29 20:25:00 srv002 pound: (42cf0960) backend 127.0.0.1:10080 connect: Connection timed out
エラーの原因は、単純に pound2.cfg の設定不足でした・・・orz。
pound 2系のコンフィグ
pound は 1 系と 2 系でコンフィグのフォーマットが全然違うので、やっぱりやっちゃいました。2 系の専用パラメータでタイムアウト値をちゃんと設定してやる必要がありました。※ドキュメントに記述されていない?のでソースから解析しました。
下記のように Client と TimeOut の値を設定してやる必要があります。※意外とコンフィグの書き方に躓いたので設定値を全部載せておきます。
User         "apache"
Group        "apache"
LogLevel     3
Alive        10
Daemon       1
LogFacility  local1
Client       300	## pound とブラウザ間のタイムアウト秒数。デフォルトは10
TimeOut      3600	## pound と apache のタイムアウト秒数。デフォルトは15

## Poundサーバの設定
ListenHTTP
    Address 10.2.130.17
    Port    80
    xHTTP   0
End

ListenHTTPS
    Address 10.2.130.17
    Port    443
    Cert    "/var/pound/cert.pem"
    Ciphers "ALL:!ADH:!EXPORT56:RC4+RSA:+HIGH:+MEDIUM:-LOW:-SSLv2:-EXP"
    xHTTP   0
End

## バックエンドサーバの設定
Service
    URL "^/cgi-bin/"
    BackEnd
        Address 127.0.0.1
        Port    8080
    End
End

Service
    URL ".*"
    BackEnd
        Address 127.0.0.1
        Port    10080
    End
End
※Client(=clnt_to)と TimeOut(=be_to)のデフォルト値は config.c で下記のように定義されています。
static int  log_level = 1;
static int  def_facility = LOG_DAEMON;
static int  clnt_to = 10;
static int  be_to = 15;
static int  n_lin = 0;
static int  dynscale = 0;
同じ設定を pound1.9 で書くと
ちなみに同じ意味合いを pound1.9 で記述するとこんな感じのコンフィグになります。
User  apache
Group apache

ListenHTTP  *,80
ListenHTTPS *,443 /usr/local/pound/cert.pem ALL:!ADH:!EXPORT56:RC4+RSA:+HIGH:+MEDIUM:-LOW:-SSLv2:-EXP

Client  300
Server 3600
Alive    10
ExtendedHTTP 1

UrlGroup "/cgi-bin/.*"
BackEnd 127.0.0.1,8080,1
EndGroup

UrlGroup ".*"
BackEnd 127.0.0.1,10080,1
EndGroup
Apache2 のチューニングへの道のり
さて話を戻しまして、pound だけの解析ではどうにも前に進まなくなりました。そこで apache2 を高負荷状態にしてみて、pound の状態がどうなるかを検証してみることにしました。
こういった検証用途には、「Slowloris HTTP DoS 攻撃について」で紹介したツールを使うと便利です。使い方は前のエントリを見ていただくとして、Slowloris で apache2 を応答不能状態にしてやったら、苦情と同じ現象を再現することができました。
perl slowloris.pl -num 1000 -port 10080 -dns localhostとやってブラウザでサイトへアクセスしてみた時の pound のエラーログがこちら。
Oct  1 14:05:54 srv002 pound: (11d4c003) connect_nb: poll timed out
Oct  1 14:05:54 srv002 pound: (11d4c003) backend 127.0.0.1:10080 connect: Connection timed out
Oct  1 14:05:54 srv002 pound: (11d4c003) BackEnd 127.0.0.1:10080 dead (killed)
Oct  1 14:05:54 srv002 pound: (11d4c003) e503 no back-end "GET / HTTP/1.1" from 10.0.0.40
Oct  1 14:06:00 srv002 pound: (11d58003) e503 no back-end "GET /style/top.css HTTP/1.0" from 10.0.0.40
・・・・
Oct  1 14:06:04 srv002 pound: BackEnd 127.0.0.1:10080 resurrect
ここまできてやっと、そもそも高負荷時に apache2 のプロセス数が足りていなく、静的コンテンツの応答時間が遅延しているのかも?という仮説を立てることができました。
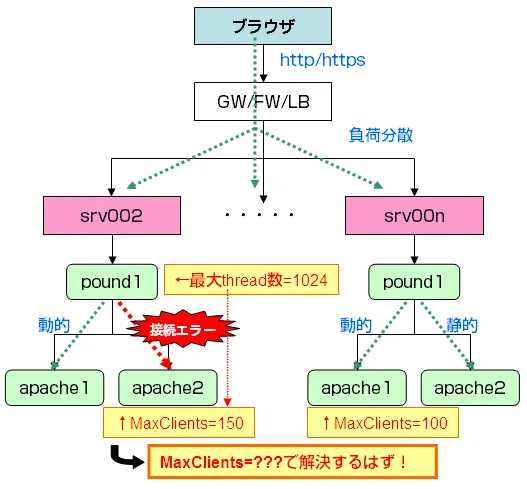
図解するとこんな感じです。pound の最大 thread 数は 1024 あるのに、静的コンテンツを受け持つ apache2 の MaxClients は srv002 で 150、srv00n で 100 しかありません。pound から apache2 への接続のところでエラーになっている、という見立てです。
結論: pound と apache の設定値のアンバランス
さて、やっと結論です。ここまで読んで下さって有難う御座います!
今回の問題点は、pound の設定値と apache の設定値のアンバランスにありました。pound 側はまだ受付可能な状態にあるにもかかわらず、apache2 が応答待ち状態になっているので、ブラウザ側は応答待ち状態(真っ白画面 or フリーズ)になるというわけでした。
というわけで、今回の事象の解決方法としては apache のチューニングとなります。チューニングの話は次エントリで!